
 技能提升网
队列深度每分钟都在增加,值班人员把消费者翻倍,数据库响应随后更慢,积压仍没下降。消费者数量增加了,业务成功处理的速度却没有增加。诊断应先回答消息为什么留在队列里。
图表上几条速率要使用同一口径
收集队列名称、时间窗口、生产速率、投递速率、业务成功、确认、重试和最老消息年龄。队列可见待取数量与已投递未确认数量分开,不能只看一根队列深度线。不同监控系统的采样时点和单位统一,峰值不拿来与另一个窗口平均值相减。
生产者发送成功与业务消费完成不同。以RabbitMQ为例,publisher confirms与消费者确认属于不同环节,不能互相证明。重投递标记提示需要追查重复处理,仍需业务日志确认真正成功或失败,不凭消息离开队列就认定订单已完成。
incident-response可协助梳理影响范围、变化时间和验证假设。日志提供脱敏的消息标识、耗时和错误类型,不给AI真实支付或客户载荷。事件排查权限只读起步,扩容、暂停和清队列是另外的操作授权。
净流入告诉你积压会不会继续长
假设新任务每秒进入一百二十条,业务成功完成每秒八十条,在没有重试或其他出入的简化条件下,每秒净增四十条,一分钟增加两千四百条。待处理两万四千条若生产完全暂停,以八十条每秒需要三百秒,即五分钟。
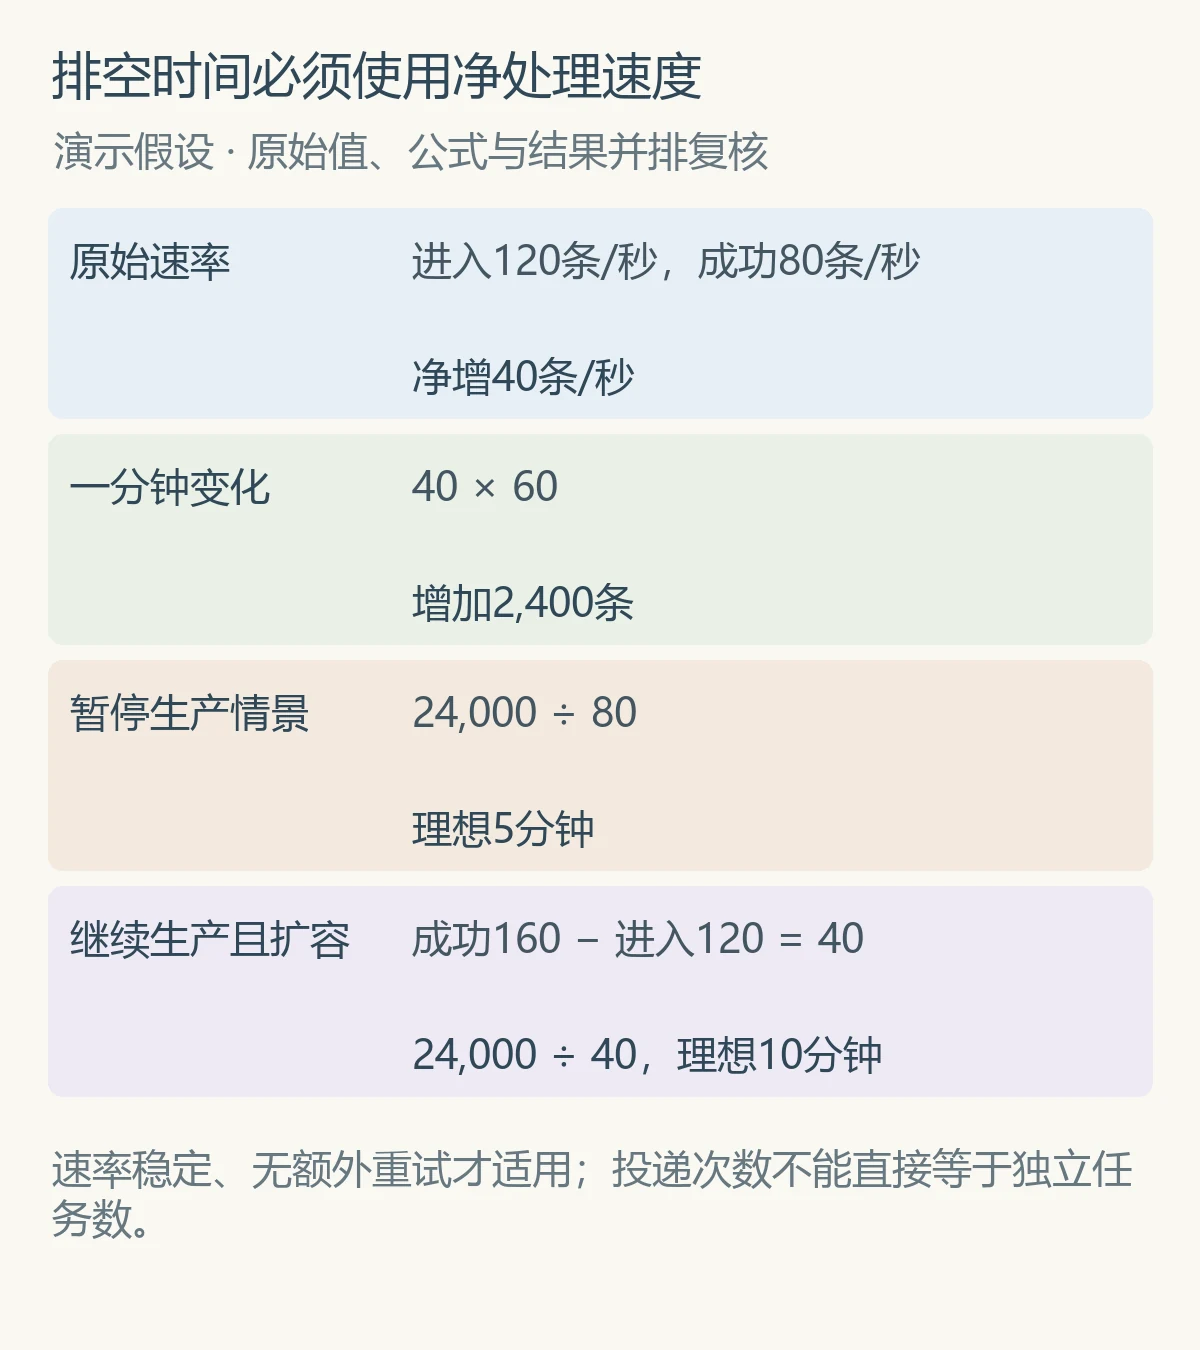
如果生产仍是每秒一百二十条,按现有速度就不会排空,不能报告五分钟恢复。若通过措施达到成功处理每秒一百六十条,净排空速度四十条每秒,两万四千条理想约需十分钟。计算假定速率稳定且没有新失败,报告明确这些条件。
Metrics Review可辅助比较同窗口速率、最老年龄和错误分布。某些重试会再次进入队列,某些留在延迟队列,定义不同就会影响净流入;先画清消息去向,再使用公式,不能把投递次数都当独立任务数量。
慢在哪里,从处理链分段看
把消费者的解析、数据库、外部请求和提交确认耗时拆开,与部署、配置及流量变化对齐。消费者CPU低但请求耗时高,可能等下游;CPU饱和则需要查本地计算、序列化和负载。监控关联只是线索,具体瓶颈通过相同请求的链路及受控测试确认。
未确认数量很高时,检查消费并发、预取和确认逻辑;错误重投很多时检查失败消息是否反复占用资源。某类载荷每次失败可能是毒消息,按批准策略隔离到专门队列并保留原始记录。不能直接丢弃来让积压数字下降。
消费者数增加可能让数据库连接、锁或第三方限额更紧。先核查下游余量,限制并发并观察业务成功率。预取值没有通用最优数字,按消息体积、处理时间和资源测试,不让AI依据队列深度自动把参数调大。
消息大小及处理类型也影响吞吐。同样一千条任务,短文本通知和大文件转换的工作量不同,应按任务类型及资源分组。少量长任务阻塞时,检查调度与超时策略是否适当,而不是只把消费者平均耗时作为全部任务的特征。
观测到错误率上升时,保存具体错误和首次出现时间。第三方限流、数据校验失败和网络断开需要不同处理,重试次数越多不代表恢复越快。已批准的退避策略和隔离条件写入恢复单,恢复后核对隔离任务的最终业务去向。
恢复动作必须保留业务约束
暂停非关键生产、给优先任务分流或小步扩容,各自有业务影响。涉及订单、库存和财务的消息要确认顺序及幂等要求,补跑时避免重复执行。即使中间件提供确认机制,业务侧仍要处理重投或超时造成的重复。
设定小批试行、观察窗口和回退条件,监控最老消息年龄、成功速率、错误及下游延迟。只看到ready数量下降但未确认大量增加,不能宣告恢复。达到稳定服务目标以后,继续核对业务完成与任务源总数。
交付事件时间线、瓶颈证据、操作记录和未完成消息清单。失败任务由指定负责人补处理,原队列及隔离队列数量都要有解释。复盘将缺失监控和重试策略补齐,下次报警使用最老任务与业务失败一起判断,不只用队列长度触发。
